
从一个普通的大语言模型,到一个能够自主思考、调用工具、执行任务的 AI Agent,中间究竟发生了什么?这篇文章带你从零理解 Harness,并通过 DeepSeek Harness 动手搭建一个真正能够干活的 Agent。
前言
最近在研究 AI Agent 的过程中,我发现一个词出现的频率越来越高:Harness。
无论是 Claude Code、Codex,还是各种 Coding Agent,背后都离不开一个重要概念:Harness。
刚开始接触这个词的时候,我其实也有点摸不着头脑。
我们平时使用 DeepSeek、ChatGPT,不就是输入问题,然后 AI 返回答案吗?为什么还需要一个 Harness?
后来我逐渐发现,大语言模型虽然很聪明,但它本身并不能直接操作电脑、读取文件、执行命令,也不能天然地记住所有任务状态。
如果想让 AI 真正成为一个能够干活的 Agent,就需要在模型外面搭建一套完整的运行机制。
这套机制,就是我们今天要介绍的 Harness。
本文会从一个初学者的角度,依次讲清楚:
Harness 到底是什么?
一个 Harness 通常由哪些部分组成?
Harness 是如何驱动 Agent 完成任务的?
如何使用 DeepSeek Harness,从零搭建一个 Agent 项目?
一、Harness 到底是什么?
1.1 先理解一个问题:大模型本身能做什么?
我们先不急着理解 Harness,先想一个简单的问题。
假设你打开 DeepSeek,输入:
帮我整理一下电脑桌面上的文件,把图片放到图片文件夹,把 PDF 放到文档文件夹。
DeepSeek 会怎么做?
它可能会告诉你:
创建一个图片文件夹。
创建一个文档文件夹。
找到桌面上的图片。
将图片移动到图片文件夹。
将 PDF 移动到文档文件夹。
它甚至可以给你写一段 Python 代码。
但是,有一个问题:
它真的能够直接帮你操作电脑吗?
答案是:仅仅通过普通的模型对话,它做不到。
因为大语言模型本质上是一个根据输入生成输出的模型。它可以理解你的需求、分析问题、生成代码,但它并不天然拥有访问电脑文件、执行命令、调用外部 API 的能力。
我们可以把它理解为一个非常聪明的大脑。
它知道应该怎么做,却不一定拥有真正执行任务的手脚。
1.2 如果给大模型装上手脚呢?
假设我们给这个大模型增加一些能力:
给它一个文件读取工具。
给它一个文件移动工具。
给它一个命令执行工具。
给它一个记忆系统。
给它一个任务管理系统。
再给它一套控制执行过程的机制。
这样,大模型就不再只是回答问题了。
它可以:
理解用户的任务。
分析应该如何完成任务。
选择合适的工具。
调用工具执行操作。
检查执行结果。
如果没有完成,就继续执行。
最终向用户汇报结果。
这时候,我们就拥有了一个真正意义上能够执行任务的 AI Agent。
那么,负责把这些能力组织起来,并让整个系统正常运行的这一层,就是 Harness。
1.3 Harness 的通俗理解
如果把 AI Agent 比作一个人:
人的组成 | AI Agent 中的对应角色 |
|---|---|
大脑 | LLM,大语言模型 |
记忆 | Memory,会话历史和持久化记忆 |
知识和经验 | Prompt、Skills、Context |
双手 | Tools,工具 |
工作环境 | Runtime,运行环境 |
工作流程 | Agent Loop,执行循环 |
行为规范 | Guardrails,安全规则 |
工作记录 | Logs、Tracing,日志和追踪 |
Harness 就像是这个人的整个工作体系。
它负责把大脑、记忆、工具、工作环境和执行流程组织起来,让 AI 能够持续完成任务。
可以用一个非常简单的公式理解:
Agent = LLM + Harness
这里的 Harness 不是某一个固定的软件包,而是围绕模型建立起来的一整套运行时机制。
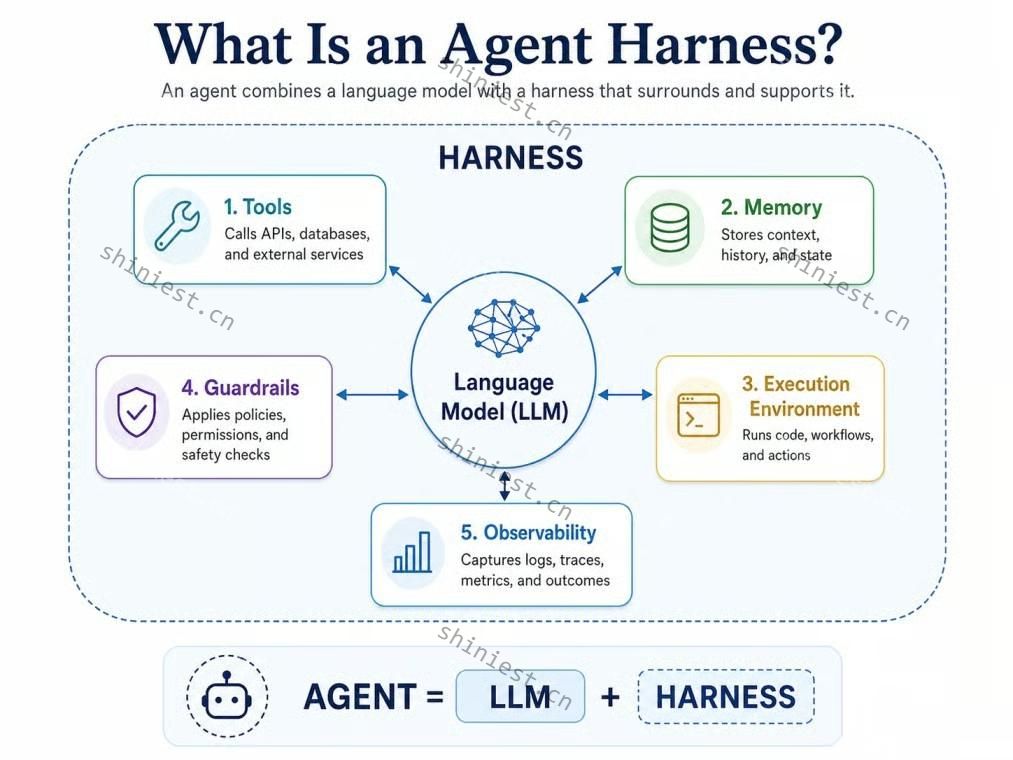
1.4 Harness 和 Agent Framework 有什么区别?
这里再补充一个容易混淆的概念。
我们经常听到 LangChain、AutoGen、CrewAI 等 Agent 开发框架。
它们和 Harness 是不是一回事?
其实并不完全相同。
可以这样理解:
Agent Framework:提供开发 Agent 的工具箱,帮助开发者组装各种能力。
Harness:把这些能力真正组织起来,形成一个能够持续运行的 Agent 运行环境。
Agent:最终对外提供智能任务执行能力的系统。
打个比方:
Framework 像是汽车零件和组装工具,Harness 像是汽车的整套运行控制系统,而 Agent 就是最终能够开起来的汽车。
它们之间存在交集,但关注点不同。
二、Harness 由哪些部分组成?
理解了 Harness 的基本概念,我们再来看它内部到底有哪些东西。
实际上,不同 Harness 的具体架构会有区别,并不存在一个绝对统一的标准。
但从一个完整 Agent 的运行需求出发,我们可以把 Harness 拆成下面几个核心部分。
2.1 整体架构
一个典型的 Agent Harness,可以抽象成下面的结构:
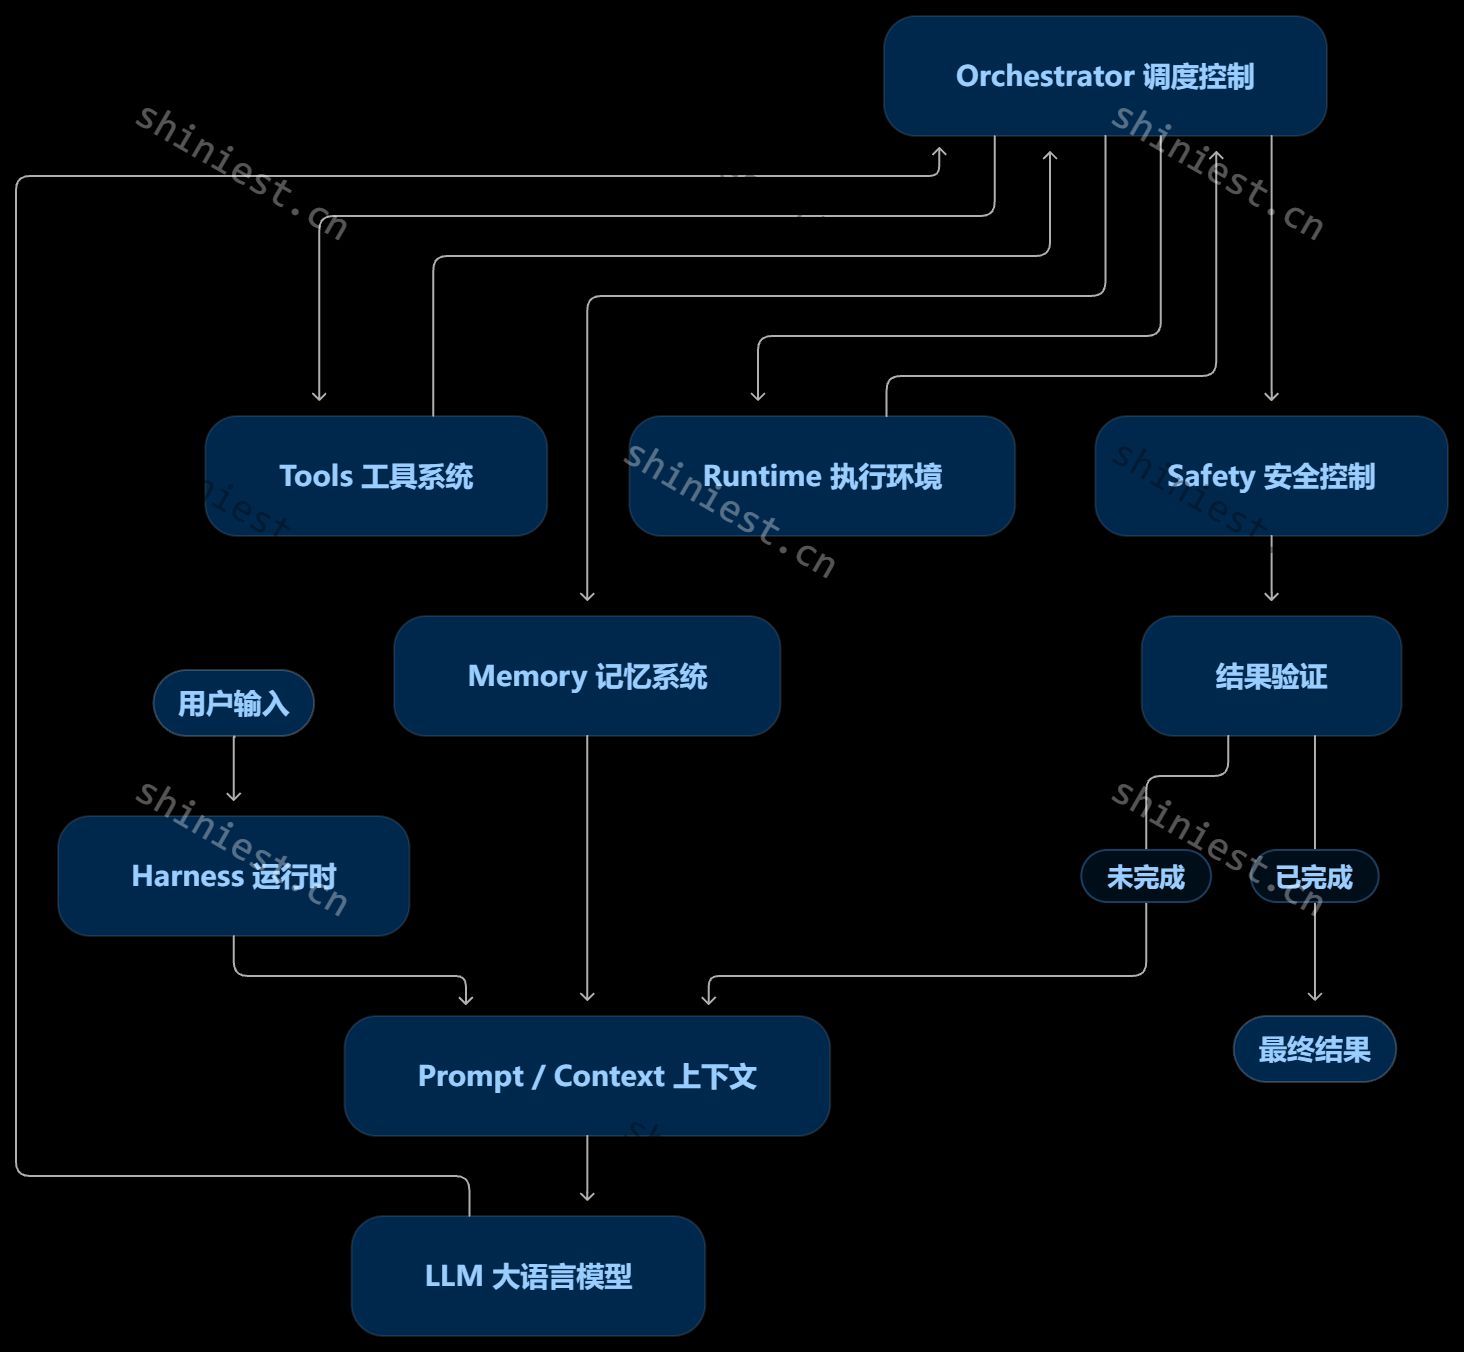
接下来逐一解释。
2.2 LLM:大脑
LLM 就是我们熟悉的大语言模型,例如:
DeepSeek
GPT
Claude
Gemini
Qwen
它主要负责:
理解用户的意图。
分析当前任务。
推理下一步应该做什么。
决定是否需要调用工具。
根据执行结果调整后续计划。
需要注意:
LLM 负责思考和决策,但工具的实际执行通常由 Harness 中的程序负责。
例如:
用户说:
帮我统计一下项目中有多少个 Vue 文件。
模型可以判断需要遍历项目文件,然后决定调用文件搜索工具。
但是,真正遍历文件的操作,是工具执行的,而不是模型凭空完成的。
2.3 Prompt / Context:告诉 AI 应该怎么做
Prompt 可以理解为给 AI 的工作说明书。
例如:
你是一个专业的软件工程助手。

你的工作目标:
帮助用户分析、修改和维护项目代码。

工作要求:
1. 修改代码之前先理解项目结构。
2. 不要随意修改无关文件。
3. 执行代码修改后,需要检查修改结果。
4. 如果遇到无法解决的问题,及时向用户反馈。
这段内容就是系统提示词的一部分。
而 Context(上下文)不只是 Prompt。
它还可能包括:
当前用户的任务。
历史对话。
当前项目的文件结构。
已经完成的任务步骤。
可用工具的描述。
Skills 中的专业知识。
当前运行环境的信息。
Prompt 更像是工作规则,Context 更像是当前工作所需的全部资料。
2.4 Tools:让 AI 真正拥有执行能力
Tools 是 Agent 非常重要的一部分。
它让模型可以从单纯生成文字,变成真正调用外部能力。
常见的工具包括:
工具 | 能力 |
|---|---|
文件读取 | 读取项目文件 |
文件编辑 | 创建、修改文件 |
Shell | 执行终端命令 |
Web Search | 搜索互联网 |
Browser | 浏览网页 |
Database | 查询数据库 |
API | 调用外部接口 |
MCP | 接入标准化的外部工具和数据服务 |
举个例子。
用户要求:
帮我查看 package.json 中使用了哪些依赖。
模型可能生成一个工具调用:
{
  "tool": "read_file",
  "arguments": {
    "path": "package.json"
  }
}
Harness 接收到这个请求之后,找到对应的工具并执行。
执行完成后,再把结果交给模型。
这里要注意:模型生成的是工具调用请求,不代表工具已经执行。真正的执行和权限控制都需要由 Harness 负责。
2.5 Memory:记忆系统
我们知道,大语言模型并不会天然记住所有历史操作。
例如:
第一轮对话:
帮我创建一个 Vue 3 项目。
第二轮对话:
再帮我添加一个登录页面。
如果系统没有保存前面的对话和项目状态,模型可能不知道之前创建了什么项目。
所以 Harness 需要管理记忆。
常见的记忆可以分成三个层次:
第一层:短期记忆
保存当前会话的对话历史。
例如:
用户提出了什么需求。
模型之前做了什么。
工具返回了什么结果。
第二层:任务记忆
保存当前任务的执行状态。
例如:
任务:创建 Vue 项目

[✓] 创建项目目录
[✓] 初始化 package.json
[✓] 安装 Vue
[ ] 创建首页
[ ] 启动项目测试
第三层:长期记忆
保存跨会话仍然需要使用的信息。
例如:
用户的开发偏好。
项目架构约定。
长期有效的业务规则。
另外,当上下文越来越长时,Harness 还需要进行 Context Compaction(上下文压缩),把历史信息整理成更精简的摘要,避免上下文无限增长。
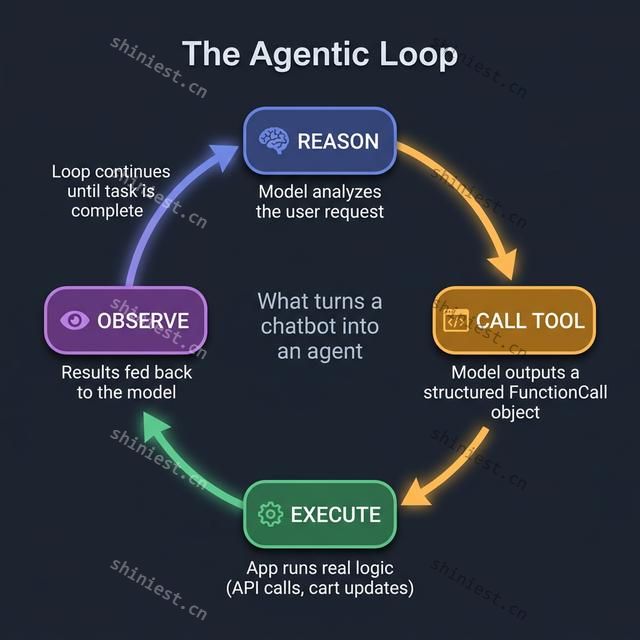
2.6 Agent Loop:让 AI 可以持续工作
这是 Harness 最核心的机制之一。
为什么这么说?
因为一个真正的 Agent,通常不是调用一次模型就结束了。
它需要不断执行:
思考 → 行动 → 获取结果 → 再思考。
例如:
用户要求:
帮我创建一个 Vue 3 项目,并启动起来。
Agent 可能需要:
判断需要创建项目。
执行项目初始化命令。
获取执行结果。
判断项目是否初始化成功。
如果成功,继续安装依赖。
再次获取结果。
执行启动命令。
检查是否成功启动。
向用户返回结果。
这个过程可能会循环多次。
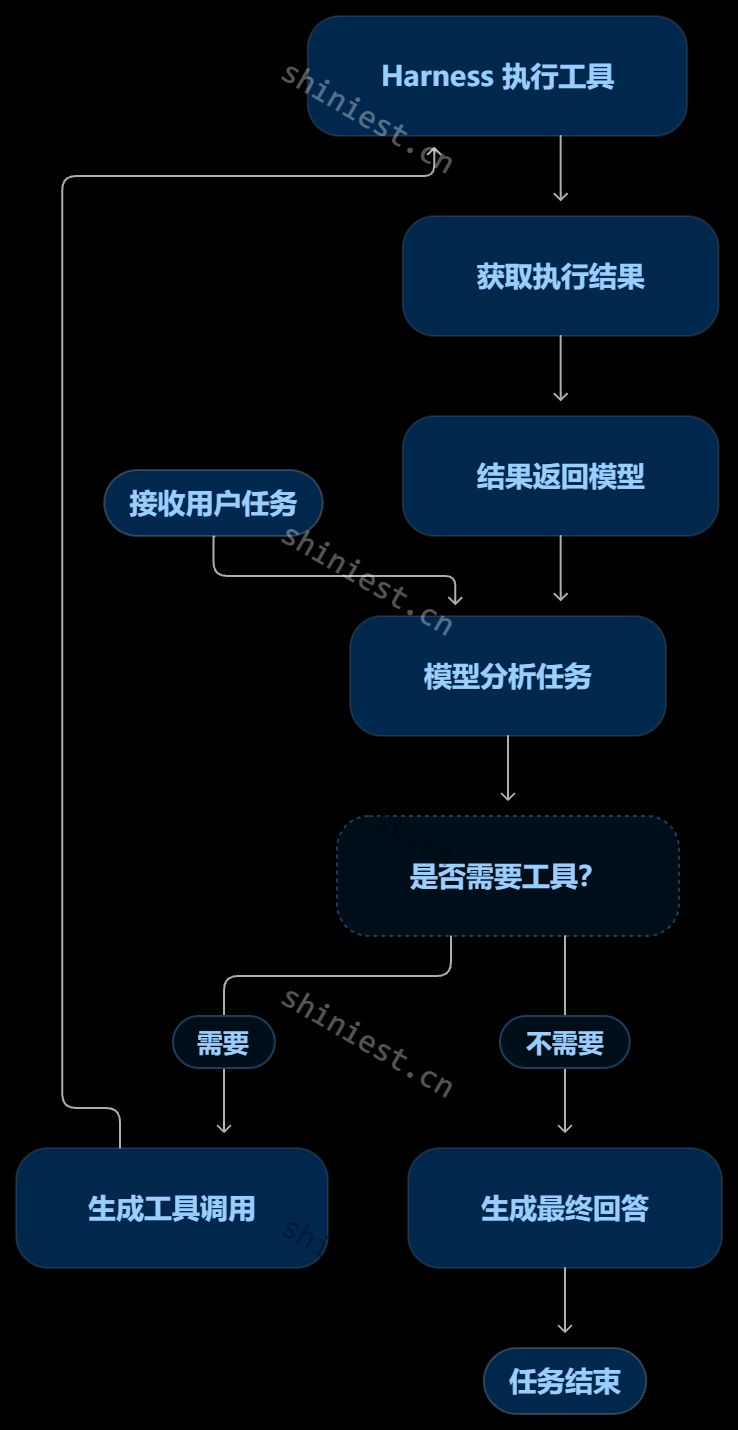
这就是 Agent Loop。
它负责控制模型请求、工具执行、结果反馈以及任务结束。
如果没有这个循环,即使模型能够生成正确的工具调用请求,也很难完成复杂的多步骤任务。
2.7 Runtime:给 Agent 提供工作环境
Runtime 可以理解为 Agent 的工作场所。
例如:
本地文件系统。
Linux Shell。
Windows PowerShell。
Docker 容器。
远程执行环境。
浏览器环境。
为什么需要 Runtime?
因为 Agent 调用工具时,需要有一个真实的执行环境。
比如:
模型要求执行:
npm installHarness 需要找到合适的执行环境,真正运行这条命令,然后把运行结果返回给模型。
这里还涉及一个重要问题:安全隔离。
如果 Agent 可以随意执行任何命令,那么它可能误删文件、覆盖重要数据,甚至泄露敏感信息。
因此,成熟的 Harness 通常需要结合沙箱、权限控制和人工审批机制。
2.8 Guardrails:安全控制
Guardrails 可以理解为给 Agent 设置行为边界。
例如:
不允许访问指定目录之外的文件。
删除文件之前必须经过用户确认。
执行高风险命令之前需要审批。
限制工具调用次数。
限制任务执行时间。
避免无限循环。
举个例子:
Agent 想执行:
rm -rf /importantHarness 可以在真正执行之前进行权限检查。
如果属于高风险操作,就暂停执行并请求用户确认。
这意味着:
模型可以提出行动建议,但不应该拥有不受限制的执行权。
2.9 Observability:让 Agent 的执行过程可追踪
如果一个 Agent 最终给出了错误结果,我们应该怎么排查?
只看最终回答通常是不够的。
我们还需要知道:
模型收到了什么输入?
模型做出了什么决策?
调用了哪些工具?
工具执行是否成功?
中间是否发生异常?
为什么任务提前结束?
这就是 Observability(可观测性)的价值。
它通常包括:
Logs:日志。
Tracing:执行链路追踪。
Metrics:运行指标。
Evals:任务效果评估。
一个完善的 Agent 系统,不能只关心最后有没有返回答案,还要知道整个任务是怎么完成的。
三、Harness 是如何运行的?
前面介绍了 Harness 的各个组成部分。
接下来,我们把它们串起来,看看当用户发送一条任务指令之后,Harness 内部究竟发生了什么。
3.1 用一个真实场景理解
假设用户向一个 Coding Agent 发送任务:
帮我分析当前项目,找到登录接口,并检查有没有明显的安全问题。
这个任务看起来很简单,但对于 Agent 来说,需要经历多个步骤。
第一步:接收任务
Harness 接收到用户输入。
用户任务:

分析当前项目,找到登录接口,
并检查有没有明显的安全问题。
第二步:准备上下文
Harness 会准备模型需要的信息。
例如:
系统提示词。
用户任务。
当前项目目录。
当前会话历史。
可使用的工具列表。
已有任务状态。
然后把这些内容组合成模型请求。
第三步:模型分析任务
模型分析后发现,需要先了解项目结构。
于是决定调用文件搜索工具。
例如:
{
  "name": "search_files",
  "arguments": {
    "pattern": "login",
    "directory": "src"
  }
}
第四步:Harness 执行工具
Harness 收到工具调用请求后:
检查工具是否存在。
检查参数是否符合要求。
检查是否拥有执行权限。
执行对应工具。
获取执行结果。
假设结果是:
找到以下文件:

src/api/login.ts
src/views/Login.vue
src/utils/auth.ts
第五步:把结果返回给模型
Harness 将工具执行结果添加到会话记录中,再次请求模型。
此时模型已经知道项目中存在三个与登录相关的文件。
它可能进一步决定:
我需要读取 login.ts,检查登录接口的请求和响应逻辑。
于是再次调用文件读取工具。
第六步:持续执行和验证
模型读取代码后,发现登录接口使用了 Token。
它可能继续检查:
Token 是否正确保存。
是否存在敏感信息泄露。
是否有明显的认证逻辑问题。
是否存在不合理的错误处理。
如果还需要更多信息,就继续调用工具。
如果信息已经足够,就生成最终报告。
第七步:结束任务
当模型判断任务已经完成,Harness 检查是否还有未完成的工具调用或待处理任务。
如果没有,就结束当前任务,并将最终结果返回用户。
3.2 完整执行流程图
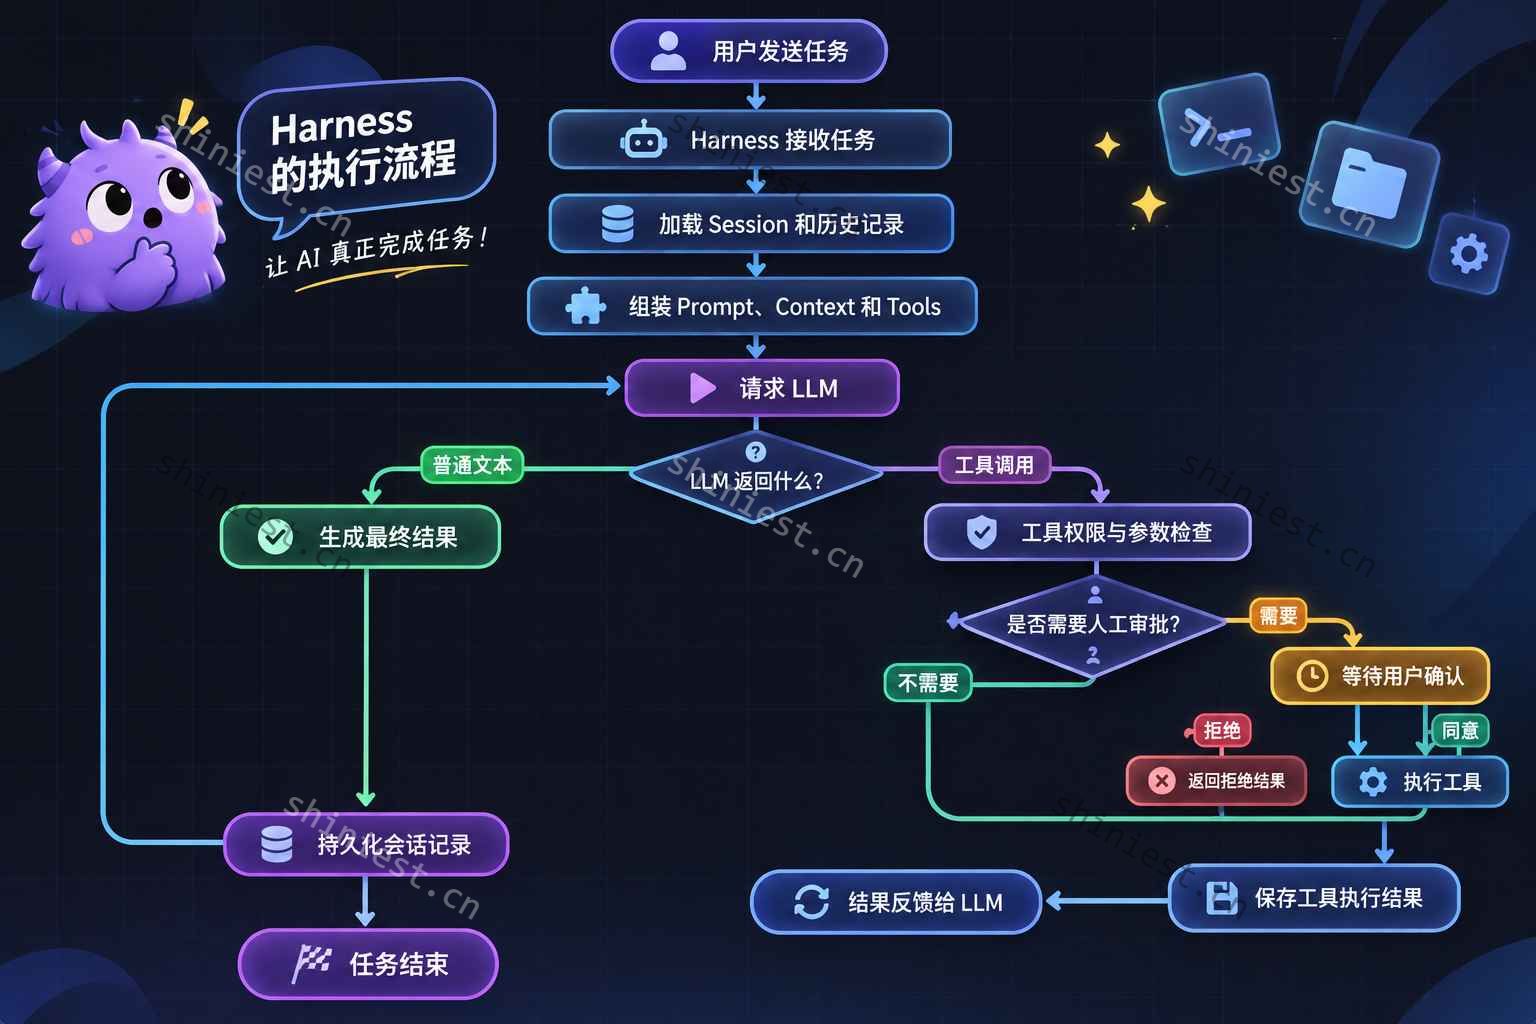
可以看到,Harness 并不是简单地把用户输入转发给模型。
它在整个过程中承担着:
上下文管理。
模型请求。
工具调度。
权限控制。
结果反馈。
状态持久化。
任务结束判断。
这些工作共同构成了一个完整的 Agent 运行时。
四、使用 DeepSeek Harness 从 0 到 1 搭建一个 Agent 项目
理论讲完了,接下来进入实战。
这次我们使用 DeepSeek 官方开源项目:DeepSeek Harness(简称 dsh)。
项目地址:
https://github.com/deepseek-ai/deepseek-harness
官方文档:
https://deepseek-harness.github.io/deepseek-harness/
需要说明的是,DeepSeek Harness 本身就是一个 Agent Harness。我们不是单纯调用 DeepSeek API 写一个聊天机器人,而是使用它提供的 Agent 运行环境、工具和工作区能力,完成一个实际项目。

本次实战的目标是:
搭建一个能够读取项目文件、执行命令、分析问题并修改代码的个人 Coding Agent。
4.1 准备开发环境
首先准备以下环境:
环境 | 作用 |
|---|---|
Node.js | 运行 DeepSeek Harness |
npm | 安装和启动项目 |
DeepSeek API Key | 调用 DeepSeek 模型 |
一个独立项目目录 | 作为 Agent 的工作区 |
建议使用较新的稳定版 Node.js。
另外,DeepSeek Harness 目前处于开发者预览阶段,功能和配置可能持续变化,实际操作时以官方文档为准。
4.2 安装 DeepSeek Harness
最简单的方式是直接通过 npx 启动。
打开终端,执行:
npx @deepseek-ai/dsh web首次执行时,npx 会获取所需的软件包并启动 Web UI。
默认情况下,本地访问地址为:
http://127.0.0.1:3080启动成功后,浏览器会打开 DeepSeek Harness 的操作界面。
如果没有自动打开,也可以手动访问上面的地址。
4.3 配置 DeepSeek 模型
打开 DeepSeek Harness 页面后:
进入 Settings(设置)。
找到 Model(模型)。
找到 DeepSeek 模型配置。
填入 DeepSeek API Key。
保存配置。
API Key 可以在 DeepSeek 开放平台申请:
https://platform.deepseek.com/
模型配置完成后,下一次请求就可以使用新的配置,不需要重启服务。
目前 DeepSeek API 官方推荐使用的模型标识为:
deepseek-flash具体模型可用性以官方模型目录为准。
这里需要注意:
API Key 是调用模型服务的凭证,不要把它直接写进项目代码,也不要提交到 Git 仓库。
4.4 创建 Agent 工作区
接下来,我们创建一个独立的项目目录。
例如:
mkdir my-first-agent
cd my-first-agent
这个目录就是 Agent 的 Workspace(工作区)。
可以把 Workspace 理解为 Agent 的工作桌面。
Agent 后续读取文件、创建代码、修改文件和执行项目命令,都围绕这个工作区展开。
回到 DeepSeek Harness:
点击选择工作区。
添加刚刚创建的
my-first-agent目录。选中该目录。
创建一个新的会话。
至此,模型和工作区就已经连接起来了。
4.5 让 Agent 完成第一个任务
现在可以给 Agent 发送第一条指令:
请先分析当前工作区。

1. 查看当前项目目录结构。
2. 检查是否存在已有项目文件。
3. 总结项目当前的状态。
4. 不要直接修改任何文件。
5. 给出下一步开发建议。
你会发现,Agent 不只是返回一段文字。
它会根据自己的判断调用工具:
查看工作区。
读取文件。
执行必要的命令。
如果某个操作需要审批,Harness 会根据当前权限策略向用户请求确认。
这就是 Harness 与普通聊天机器人的区别。
4.6 开始搭建一个真正的 Agent 项目
为了让实战更有意义,我们不只是让 Agent 帮忙写代码,而是让它完成一个完整的小项目。
这里选择:
个人文件整理助手(File Assistant)
项目目标:
用户给出一个目录,Agent 能够分析里面的文件,并根据用户的要求进行分类和整理。
第一版实现以下功能:
扫描指定目录。
统计文件数量。
根据扩展名识别文件类型。
生成文件分类报告。
根据用户确认执行文件整理。
整理完成后再次检查结果。
这个项目不需要复杂的数据库,也不需要复杂的前端界面,非常适合入门。
第一步:让 Agent 设计项目结构
在 DeepSeek Harness 中输入:
现在请帮我创建一个 Python 项目:

项目名称:File Assistant

项目目标:
实现一个个人文件整理助手。

技术要求:
1. 使用 Python 3.11+。
2. 使用模块化结构。
3. 代码需要有清晰的注释。
4. 不需要数据库。
5. 不需要前端页面。

请先设计项目结构,并解释每个文件的作用。

暂时不要创建文件,等待我确认。
Agent 会根据任务分析项目,并给出建议。
例如:
file-assistant/
│
├── main.py
│
├── agent/
│   ├── __init__.py
│   ├── planner.py
│   └── executor.py
│
├── tools/
│   ├── __init__.py
│   ├── file_scanner.py
│   ├── file_classifier.py
│   └── file_mover.py
│
├── config/
│   └── settings.py
│
├── requirements.txt
│
└── README.md
这里我们有意把 Agent 的决策逻辑和实际文件操作拆开。
planner.py:负责任务规划。
executor.py:负责执行流程。
file_scanner.py:负责扫描文件。
file_classifier.py:负责文件分类。
file_mover.py:负责移动文件。
这样后续增加功能时,不需要把所有代码都堆在一个文件中。
第二步:让 Agent 创建项目文件
确认结构后,输入:
项目结构没有问题。

现在按照刚刚确定的结构创建项目文件。

要求:

1. 完成每个模块的基础代码。
2. 文件扫描需要支持递归遍历。
3. 文件分类需要支持图片、文档、视频、音频和其他文件。
4. 文件移动功能需要检查目标目录。
5. 移动文件之前必须支持预览模式。
6. 不允许覆盖同名文件。
7. 不允许删除原始文件。

完成后检查所有代码。
Agent 会开始执行:
创建目录。
创建 Python 文件。
编写代码。
检查文件内容。
你可以在执行过程中观察工具调用和文件变化。
这里要特别注意:不要为了追求自动化而关闭所有权限限制。文件移动属于有副作用的操作,应该先预览,再由用户确认。
第三步:测试项目
文件创建完成后,继续输入:
现在开始测试项目。

1. 检查 Python 语法。
2. 检查模块导入。
3. 检查是否存在明显的逻辑问题。
4. 为核心文件分类逻辑编写测试。
5. 执行测试并修复发现的问题。

不要修改无关文件。

最后输出测试报告。
Agent 会根据任务调用终端工具,执行测试命令。
例如:
python -m compileall .如果项目配置了 pytest,还可以执行:
pytest -q测试失败时,Agent 可以读取错误信息、分析问题、修改代码,再次运行测试。
这就是一个典型的 Agent Loop:
模型分析 → 调用工具 → 获取结果 → 再次分析 → 继续执行。
第四步:验证最终效果
项目完成后,可以给 Agent 一条测试任务:
请扫描当前工作区中的测试目录。

要求:

1. 统计文件总数。
2. 按照文件类型分类。
3. 输出分类统计报告。
4. 生成文件整理预览。
5. 不要实际移动文件。
假设测试目录中有:
test-files/
├── photo1.jpg
├── photo2.png
├── document1.pdf
├── document2.docx
├── video1.mp4
└── music1.mp3
Agent 预期生成:
文件统计报告

总文件数:6

图片:2
文档:2
视频:1
音频:1
其他:0

建议整理方案:

images/
  photo1.jpg
  photo2.png

documents/
  document1.pdf
  document2.docx

videos/
  video1.mp4

audios/
  music1.mp3

当前为预览模式,没有移动任何文件。
如果预览结果正确,再让 Agent 在用户确认后执行整理。
这样,一个简单的文件整理助手就完成了。
4.7 从实战中理解 Harness 的价值
回过头来看,我们刚才的整个操作过程,其实就是 Harness 在发挥作用。
我们可以把每个操作和 Harness 的组成部分对应起来:
实际操作 | 对应的 Harness 能力 |
|---|---|
理解用户需求 | LLM |
分析项目结构 | Context + Tools |
制定开发计划 | Agent Loop |
创建 Python 文件 | 文件系统工具 |
执行 Python 命令 | Runtime |
测试代码 | Tools + Verification |
记录对话和执行结果 | Session / Memory |
操作前请求确认 | Approval / Guardrails |
查看任务执行过程 | Logs / Observability |
这也是为什么 Harness 不只是一个模型调用器。
它实际上是整个 Agent 的运行基础设施。
五、DeepSeek Harness 本身是如何设计的?
前面我们使用 DeepSeek Harness 完成了一个小项目。
如果想进一步理解它,就需要了解它自己的内部架构。
这里不深入源码实现,只介绍几个比较重要的设计概念。
5.1 一切皆插件(Everything is a Plugin)
DeepSeek Harness 有一个非常重要的设计理念:
Everything is a Plugin(一切皆插件)。
它的底层使用 Cordis 作为插件框架。
简单来说,模型适配器、工具注册表、会话管理,甚至 Agent Loop 本身,都可以作为插件参与运行。
这意味着:
可以替换模型提供商。
可以增加新的工具。
可以扩展文件系统能力。
可以替换或调整执行逻辑。
可以通过配置组合不同的运行能力。
这种设计相比把所有功能写死在一个核心程序里,更加灵活。
5.2 Profile:运行配置组合
DeepSeek Harness 中还有一个重要概念:Profile。
可以把 Profile 理解为一套预先定义好的运行配置。
官方提供了多个 Profile,例如:
Profile | 主要用途 |
|---|---|
web | Web UI 交互 |
headless | 无界面运行 |
sdk | SDK 集成 |
sdk-minimal | 精简 SDK 运行 |
acp | 自动化协议接入 |
不同 Profile 会组合不同的插件和能力。
例如,Web Profile 更适合通过浏览器使用 Agent,而 SDK Profile 更适合在自己的程序中集成 Agent。
5.3 Bundle:插件组合包
如果 Plugin 是一个个独立能力,那么 Bundle 可以理解为一组插件的组合包。
它负责将相关插件和配置组织起来,方便复用和分发。
Profile 则可以按顺序组合多个 Bundle。
因此,DeepSeek Harness 的配置不是简单地在一个配置文件里写一堆开关,而是通过分层组合来构建运行环境。
5.4 Session:会话管理
Session 用来管理一次 Agent 会话中的状态和执行记录。
它不仅仅是普通聊天记录。
在 DeepSeek Harness 中,会话事件会记录用户输入、模型消息、工具调用以及工具执行结果等信息。
这些记录可以用于:
恢复会话。
重建模型上下文。
查看执行过程。
追踪失败步骤。
继续尚未完成的任务。
这对于长时间运行的 Agent 尤其重要。
5.5 Agent Loop:真正驱动任务执行
DeepSeek Harness 的 Agent Loop 负责驱动整个执行过程。
一次完整的任务执行会涉及:
接收待处理输入。
组装模型请求。
请求模型。
处理模型输出。
执行工具调用。
保存执行结果。
判断是否需要继续请求模型。
判断是否结束当前任务。
这与前面我们介绍的 Harness 通用执行流程是一致的。
如果想深入了解,可以阅读官方架构文档:
https://github.com/deepseek-ai/deepseek-harness/blob/master/docs/architecture.zh.md
六、总结:Harness 为什么越来越重要?
回到最初的问题:
为什么现在越来越多的 AI Agent 产品都在强调 Harness?
因为模型能力只是 AI Agent 的一部分。
一个模型可以很聪明,但如果它没有合适的工具、记忆、执行环境和任务控制机制,就很难稳定完成复杂工作。
同样是一个 DeepSeek 模型:
只接入聊天接口,它是一个对话助手。
增加工具调用,它可以执行简单任务。
增加记忆和上下文管理,它可以处理连续任务。
增加 Agent Loop,它可以持续推进复杂任务。
增加权限控制、沙箱和可观测性,它才能逐渐具备更可靠的工程化执行能力。
所以,我认为理解 Harness,是从普通大模型应用开发走向 Agent 工程化开发的重要一步。
最后用一句话总结:
LLM 决定 AI 有多聪明,Harness 决定 AI 如何把聪明真正转化为行动。
如果你也正在研究 AI Agent,不妨从 DeepSeek Harness 开始,亲自体验一下模型如何通过工具、上下文和执行循环,真正完成一项工作。
七、参考资料
以下是本文涉及的官方资料,建议进一步阅读:
DeepSeek Harness GitHub:
https://github.com/deepseek-ai/deepseek-harnessDeepSeek Harness 官方文档:
https://deepseek-harness.github.io/deepseek-harness/DeepSeek Harness 架构文档:
https://github.com/deepseek-ai/deepseek-harness/blob/master/docs/architecture.zh.mdDeepSeek Harness Python SDK:
https://deepseek-harness.github.io/deepseek-harness/guide/python-sdkDeepSeek API 官方文档:
https://api-docs.deepseek.com/zh-cn/DeepSeek Tool Calls:
https://api-docs.deepseek.com/zh-cn/guides/tool_calls/
本文为个人学习和实践总结,DeepSeek Harness 仍处于开发者预览阶段,具体功能和配置请以项目最新文档为准。